 - versi 2 White-AMqzvNxKRPfRLVOA.png)
Cluster Random Sampling
Cluster Random Sampling merupakan teknik pengambilan sampel yang memilih sampel secara acak dari sampling unit yang berupa kelompok atau kelas atau organisasi atau area atau wilayah. Oleh karena setiap cluster berpeluang sama untuk terpilih sebagai sampel, maka cluster random sampling masuk dalam kategori probability sampling.
Hal yang perlu dipahami adalah dalam cluster random sampling, sampling unitnya bukan lagi individu (orang / responden), melainkan kelompok, kelas, organisasi, area ataupun wilayah.
by : Danny Prasetyo Hartanto & Nur Asfi Royhan (2026)
Using The InQuest Calculator
Contoh 1
Penelitian tentang pengaruh PDRB dan inflasi terhadap PAD di Kabupaten/kota di Jawa Timur.
Contoh 2
Penelitian tentang pengaruh ESG terhadap nilai perusahaan pada perusahaan perbankan yang terdaftar di BEI periode 2020 - 2023
Contoh 3
Penelitian tentang pengaruh PDRB dan inflasi terhadap kredit di Kabupaten/kota di Jawa Timur.
Peneliti sering kali terjebak dengan perhitungan sampel menggunakan formula proporsi ataupun slovin yang notabene ditujukan pada populasi dengan unit sampling individu, bukan kelompok, area, organisasi, wilayah dll. sehingga ukuran sampel minimal yang diperoleh tidak jauh berbeda , bahkan sama dengan ukuran populasinya, yang pada akhirnya peneliti menggunakan seluruh anggota populasi untuk dijadikan sampel (sensus).
Sementara itu, ada penelitian yang pengambilan sampelnya harus dibatasi oleh pengambil kebijakan dilokasi tertentu (bukan keputusan peneliti), seperti di sekolah yang mana peneliti hanya diperbolehkan menggunakan 3 kelas, sementara promotor / penguji meminta dasar perhitungan sampel secara statistik.
Oleh karena itu, perhitungan sampel menggunakan cluster random sampling dapat peneliti gunakan.
Prinsip dari teknik Cluster Random Sampling adalah observasi / individu yang terambil dalam satu cluster bersifat heterogen, sedangkan observasi / individu antar cluster bersifat homogen.


Formula perhitungan ukuran sampel minimum pada cluster random sampling adalah sebagai berikut :


Keterangan :
n = Sampel minimum
N = ukuran populasi
Z = Nilai Normal Baku (1.96)
d = Batas toleransi kesalahan
m_bar (cluster) = rata-rata cluster
σ_square (cluster) = Ragam populasi cluster (diestimasi oleh σ_square (cluster))
Catatan Penting!
Rata-rata ukuran gerombol (m_bar) diperoleh dari penelitian pendahuluan atau penelitian terdahulu dengan variabel yang sama dengan penelitian peneliti.
Ragam populasi cluster (σ_square (cluster) diperoleh dari penelitian pendahuluan atau penelitian terdahulu dengan variabel yang sama dengan penelitian peneliti.
Jika peneliti melakukan penelitian pendahuluan, sampel cluster yang digunakan dalam penelitian pendahuluan umumnya sebanyak 5 – 10 cluster, dengan masing-masing cluster terdiri dari minimal 5 sampel.
Penentuan nilai d tidak terlepas dari tingkat representasi ukuran sampel terhadap ukuran populasinya, semakin rendah nilai d maka semakin representatif ukuran sampel terhadap ukuran populasi. Pernyataan ini sejalan dengan Teorema Limit Pusat (Central Limit Theorem) yang berbunyi semakin besar ukuran sampel maka semakin representatif atau semakin mendekati normal.
Penulis menyarankan jika populasinya besar atau bahkan terlalu besar (meskipun tidak diketahui jumlahnya) maka peneliti bisa menggunakan nilai d = 1% atau 5%. Sebaliknya jika populasi cenderung kecil maka peneliti bisa menggunakan nilai d = 10%.
Contoh :
Penelitian tentang gaya hidup karyawan PT Arena Inc. Karyawan PT Arena Inc sebanyak 2500 orang, dimana diklasifikasikan berdasarkan 4 strata masa kerja.
Strata 1 : Karyawan lama dengan masa kerja lebih dari 10 tahun (300)
Strata 2 : Karyawan lama dengan masa kerja 5 - 10 tahun (700 orang)
Strata 3 : Karyawan baru dengan masa kerja 1 - 5 tahun (900 orang)
Strata 4 : Karyawan training dengan masa kerja kurang dari 1 tahun (600 orang)
Note :
Perhitungan sampel minimum keseluruhan strata jika menggunakan alokasi proporsional dengan batas toleransi kesalahan 5%
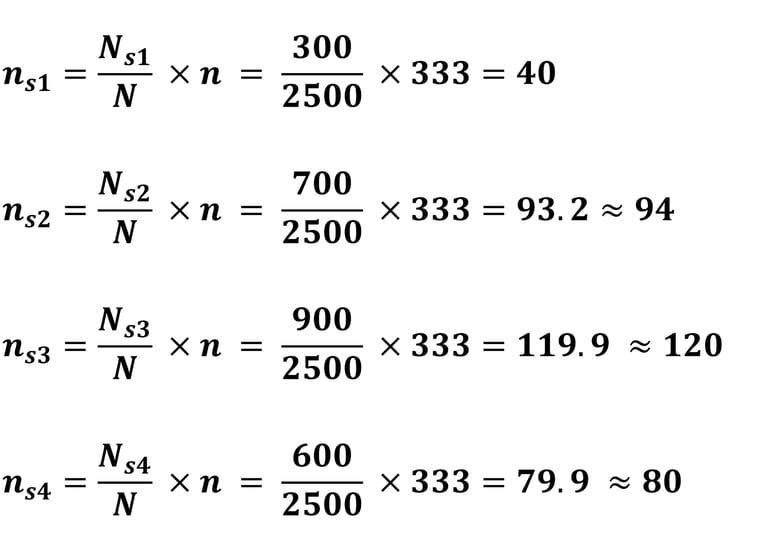
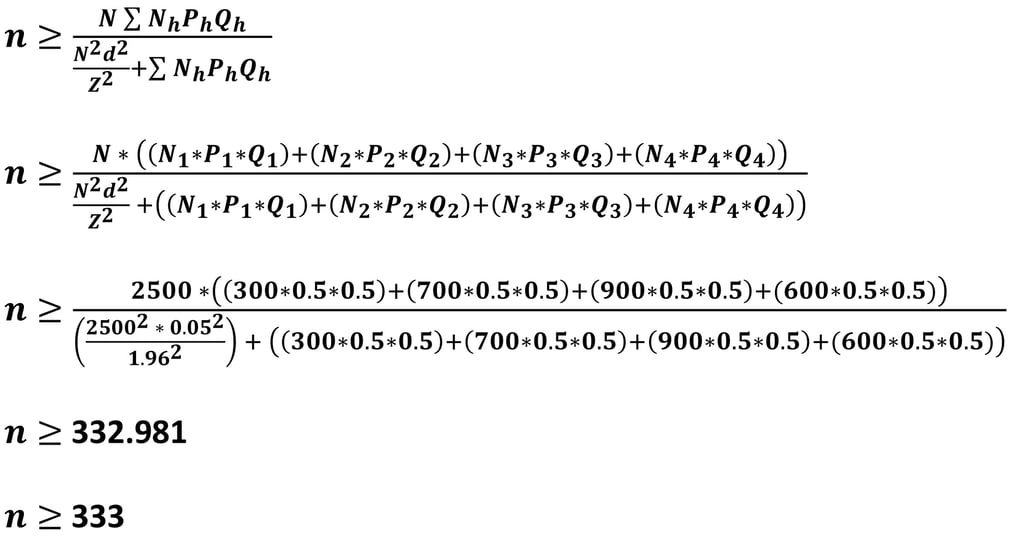
Setelah kita peroleh ukuran sampel minimum keseluruhan, selanjutnya kita hitung sampel pada masing-masing strata.
Apabila dijumlahkan sampelnya menjadi 334 (Hal ini wajar karena dalam perhitungan sampel, aturan pembulatan harus pembulatan keatas, sehingga sampel hasil perhitungan alokasi proporsional menjadi lebih besar dibandingkan sampel yang sudah dihitung (333). Karena semakin besar sampel yang digunakan maka semakin representatif (Central Limit Theorem). Jadi sampel minimum keseluruhan yang harus dipenuhi oleh peneliti bukan lagi 333, melainkan 334.
Untuk mempermudah menghitung sampel menggunakan cluster random sampling, peneliti dapat mengakses InQuest Calculator berikut :
Pembulatan dalam Ukuran Sampel
Apabila kita mencermati hasil ukuran sampel dengan d = 5% diperoleh 93.2 dibulatkan menjadi 94. Mengapa sampel tersebut dibulatkan keatas?
Bukankah secara teori jika desimal ≥ 0.5 seharusnya dibulatkan keatas menjadi 1, dan < 0.5 dibulatkan kebawah menjadi 0?
Teori tersebut memang benar, namun dalam kasus sampel teori ini tidak berlaku. Mengapa?
Alasan 1. Populasi dan sampel terkait dengan sampling unit, bisa individu, bisa organisasi, wilayah, dsb. Kita bayangkan 0.2 individu apakah kita meminta pendapat pada sebagian tubuh manusia, misalkan tangan saja atau kepala saja? tentu tidak masuk akal, maka kita meminta pendapat tubuh yang utuh, sehingga meneliti 0.2 individu sama halnya meneliti 1 individu.
Alasan 2. Kembali pada Teorema Limit Pusat (Central Limit Theorem) bahwa semakin besar ukuran sampel maka semakin representatif atau semakin mendekati normal, sehingga apabila peneliti membulatkan kebawah maka sampel menjadi 384 sehingga diperoleh d sebesar 5.03%, sedangkan apabila peneliti membulatkan keatas maka sampel menjadi 385 sehingga diperoleh d sebesar 4.9945%.
d yang diperoleh ketika peneliti membulatkan keatas tentu lebih rendah dibandingkan ketika peneliti membulatkan kebawah, sehingga dengan membulatkan keatas peneliti bisa menggunakan ukuran sampel yang lebih representatif. Dengan demikian,
"Pembulatan dalam ukuran sampel adalah pembulatan keatas"
Referensi :
Cochran, W.G. 1977. Sampling Technique. New York : John Wiley and Sons. Inc
Kish, L. 1965. Survey Sampling. New York : John Wiley and Sons, Inc
Machali, I. 2015. Statistik Manajemen Pendidikan, Teori dan Praktik Statistik dalam bidang pendidikan, Penelitian, Ekonomi Bisnis, dan Ilmu-Ilmu Sosial Lainnya. Yogyakarta : Kaukaba Dipantara
Pitard, F.F. 2019. Theory of Sampling and Sampling Practice. Washington D.C. : Chapman and Hall/CRC
Rao, P.S.R.S. 2000. Sampling Methodologies with Applications. Washington D.C. : Chapman and Hall/CRC
Scheaffer, R.L., W. Mendenhall, W. and L. Ott. 1990. Elementary Survey Sampling. 4th Edition. Boston : PWS-KENT Publishing Company
Solimun, Fernandes, A.A.R., Nurjannah. 2017. Metode Statistika Multivariat Pemodelan Persamaan Struktural (SEM) Pendekatan WarpPLS. Malang : UB Press
Walpole, R.E. 1995. Pengantar Statistika, Edisi ke-3, Jakarta : Gramedia Pustaka Utama.
Wardhani, N.W.S., Nugroho, W.H., Lusia, dan D.W., Rahmi. 2021. Teknik Sampling dan Survey (Konsep Dasar dan Aplikasi). Malang : UB Press
© Copyright by Arena Statistics. All Rights Reserved